Contrôle réception : mesurer un marché eBay sans se tromper
Un échantillon eBay tronqué fausse le flux et les prix. Comment le contrôle réception QSE a corrigé un scan de niches, sans terminal.
1. Contexte & Objectif de Terrain : un lot de 578 pièces, 200 contrôlées
À la réception, personne ne compte chaque pièce d’un camion. On prélève un échantillon, on le passe au calibre, puis on conclut sur le lot. J’ai appliqué ce réflexe à un problème qui n’a rien d’industriel : choisir des niches d’achat-revente sur eBay.
Le contexte. Un agent surveille des annonces d’occasion en Allemagne et aux États-Unis pour les revendre en France. Il fallait classer douze niches candidates (stylos plume, jumelles, montres, lampes, briquets) par écart de prix, avant d’en activer deux. Deux contraintes cadrent le travail. L’API publique ne donne que des annonces actives, jamais de ventes conclues. Et chaque appel consomme le quota quotidien de 4 500 appels que le bot de production utilise déjà.
Le paradoxe tient en une ligne. Une seule requête renvoie 200 annonces et un total de 578. Chacun de ces deux chiffres peut vous tromper, pour une raison différente.
2. Anatomie de l’Échec & Fausses Pistes : trois murs avant le premier classement
Premier mur : le prix « français » n’était pas français.
Mon hypothèse de départ : les annonces d’eBay.fr donnent le prix de revente en France. Avant d’écrire le moindre module, j’ai passé trois appels réels, un par marché (Allemagne, États-Unis, France). Les trois ont répondu 200. Le champ total et la date de création étaient présents sur toutes les annonces. Mais eBay.fr remonte aussi des vendeurs situés à l’étranger. Une médiane calculée sur tout le résultat mélange des prix français et des prix d’importation.
Deuxième mur : le test « l’échantillon est-il tronqué ? » donnait la mauvaise réponse. Mon premier réflexe était de comparer le nombre d’annonces lues à la limite de 200. Or le parsing écarte les annonces sans option de livraison vers la France, et le premier résultat eBay.de du spike n’en avait pas. Le compte d’annonces conservées passe sous 200 même quand l’API a bien coupé la liste. Le test mentait dans le sens le plus trompeur : il déclarait « lot complet » sur un lot tronqué.
Troisième mur : la fonction de recherche ne se laissait pas modifier.
Pour récupérer le champ total, il suffisait en apparence de changer le retour de la fonction de recherche. Mais un test existant remplace son mécanisme de nouvelle tentative, et d’autres modules attendent une liste en retour. Modifier la fonction aurait cassé deux choses pour en gagner une.
3. Décryptage Méthodologique par l’Analogie QSE : la réception, le calibre et la cadence
Chaque erreur a un équivalent connu en contrôle réception.
Le lot et l’échantillon. Le total de 578 est la taille du lot. Les 200 annonces lues sont le prélèvement, et ce sont les plus récentes. Quand le lot dépasse l’échantillon, on a contrôlé les dernières arrivées seulement.
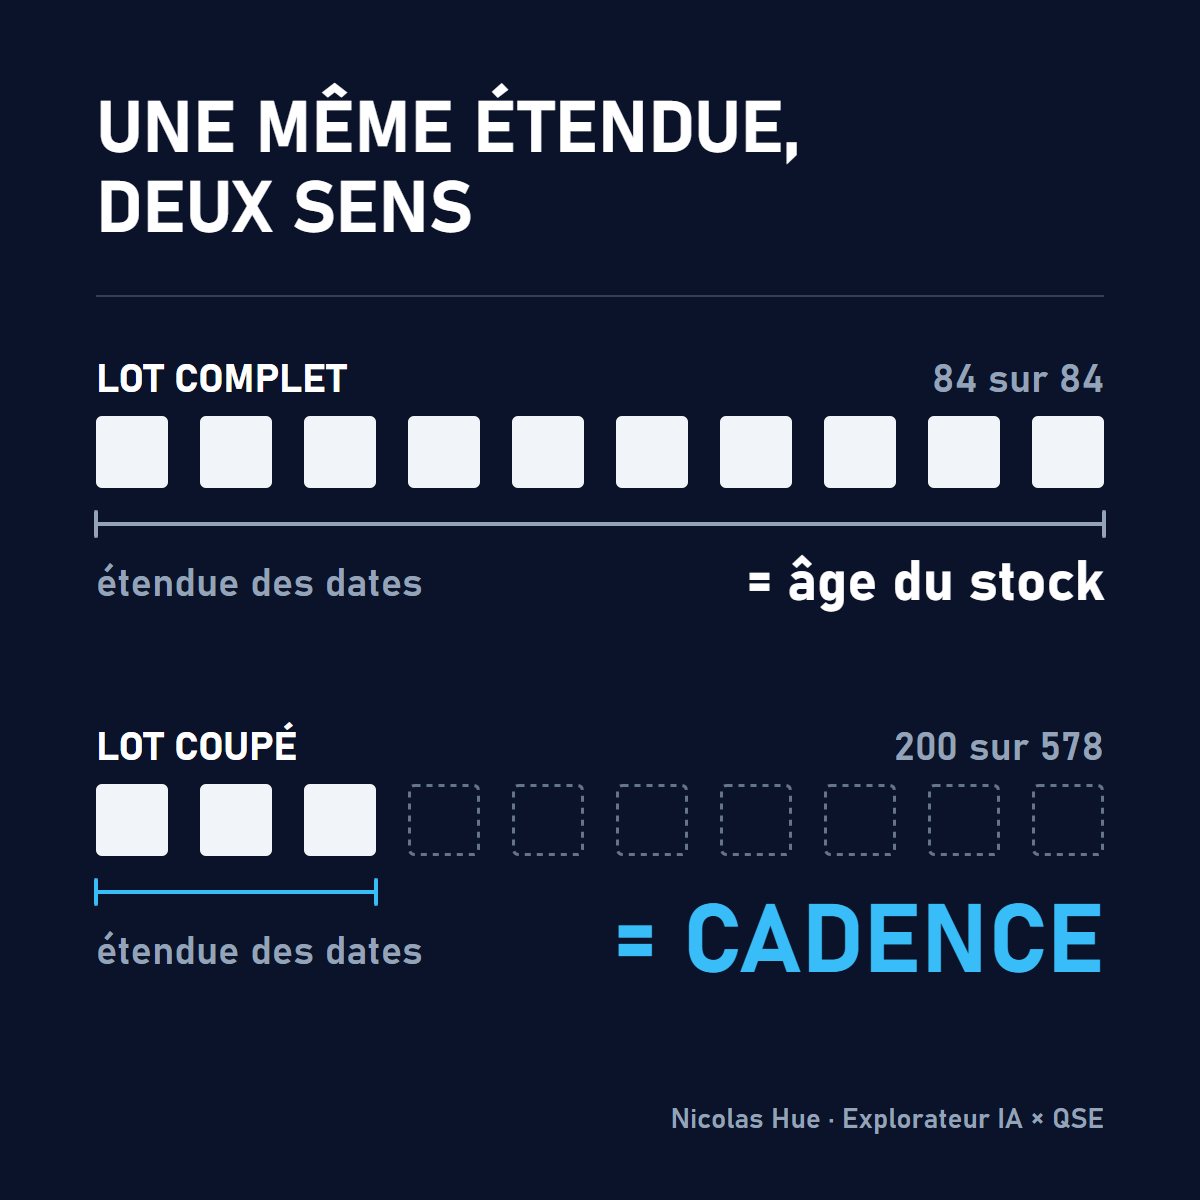
La cadence contre l’âge du stock. Quand l’API a coupé la liste, l’écart entre la première et la dernière date lue donne une cadence : 199 intervalles répartis sur une durée mesurée. Quand le lot est lu en entier, ce même écart ne donne que l’âge du stock, pas le rythme des livraisons. La règle de décision ne regarde donc pas combien de pièces ont passé le calibre, mais si le fournisseur a livré plus que ce qu’on a prélevé.
Le calibre GO / NO-GO. Le calibre de la revente en France a deux conditions : vendeur situé en France, prix au moins égal à un plancher qui écarte les accessoires. Le calibre d’achat est différent : prix port compris dans une fourchette. Deux calibres distincts pour deux flux, comme on ne mesure pas une pièce entrante avec le gabarit d’une pièce expédiée.
Le fournisseur hors périmètre. Un vendeur allemand listé sur eBay.fr, c’est une pièce hors cahier des charges dans un lot réputé conforme. On la sort avant de calculer la moyenne.
4. Le Pivot Architectural & L’Implémentation Déterministe : un critère, deux calibres, zéro dépendance
Trois décisions suivent de ces constats.
Tronqué veut dire total > limite. Le critère vient de la réponse de l’API, pas du résultat du parsing. Il ne dépend plus de ce que le filtre jette. Le flux n’est calculé que sur un échantillon tronqué, sinon la fonction rend « inconnu » plutôt qu’un chiffre faux.
def flow_per_day(created, truncated):
    if not truncated or len(created) < 2:
        return None
    span_days = (max(created) - min(created)).total_seconds() / 86400
    if span_days <= 0:
        return None
    return (len(created) - 1) / span_days

def _pool(candidate, market, items):
    if market == "EBAY_FR":  # calibre de revente : vendeur FR, plancher de prix
        return [i.cost_eur for i in items
                if i.country == "FR" and i.cost_eur >= candidate.price_min_eur]
    return [i.cost_eur for i in items  # calibre d'achat : fourchette, port compris
            if candidate.price_min_eur <= i.cost_eur <= candidate.price_max_eur]

flow = flow_per_day([i.created_at for i in items], total > limit)
Ces deux fonctions sont pures : mêmes entrées, même sortie, aucune horloge, aucun réseau. C’est ce qui permet de les tester sans appeler eBay.
Deux fonctions de recherche partagent un seul corps. La première renvoie la réponse complète, total inclus. La seconde garde sa signature et son retour d’origine. Les deux portent le même mécanisme de nouvelle tentative, et chaque tentative est facturée sur le compteur de quota. Aucun test existant n’a bougé.
Un seul critère de classement. L’écart brut, c’est la médiane française moins la médiane de la source. Pas de score pondéré, pas de découverte automatique, aucune dépendance ajoutée. L’humain lit le tableau et valide les finalistes sur les sites de revente. Le scan, lui, refuse de démarrer si les appels du jour plus son propre budget dépassent le plafond moins 500 appels, réservés au bot de production.
5. Données Chiffrées, Benchmarks & Résultats Mesurés : 36 appels, 18 tests, un classement à relire
Ce que la session a mesuré :
- Spike : 3 appels, code 200 sur les 3 marchés. Allemagne et France renvoient chacun un total de 84 pour la même requête, les États-Unis 578.
- Tests : 18 nouveaux, la suite complète passe de 538 à 556 tests réussis. Le module du scan pèse 506 lignes réparties sur 7 fichiers, aucun ne dépasse 122 lignes.
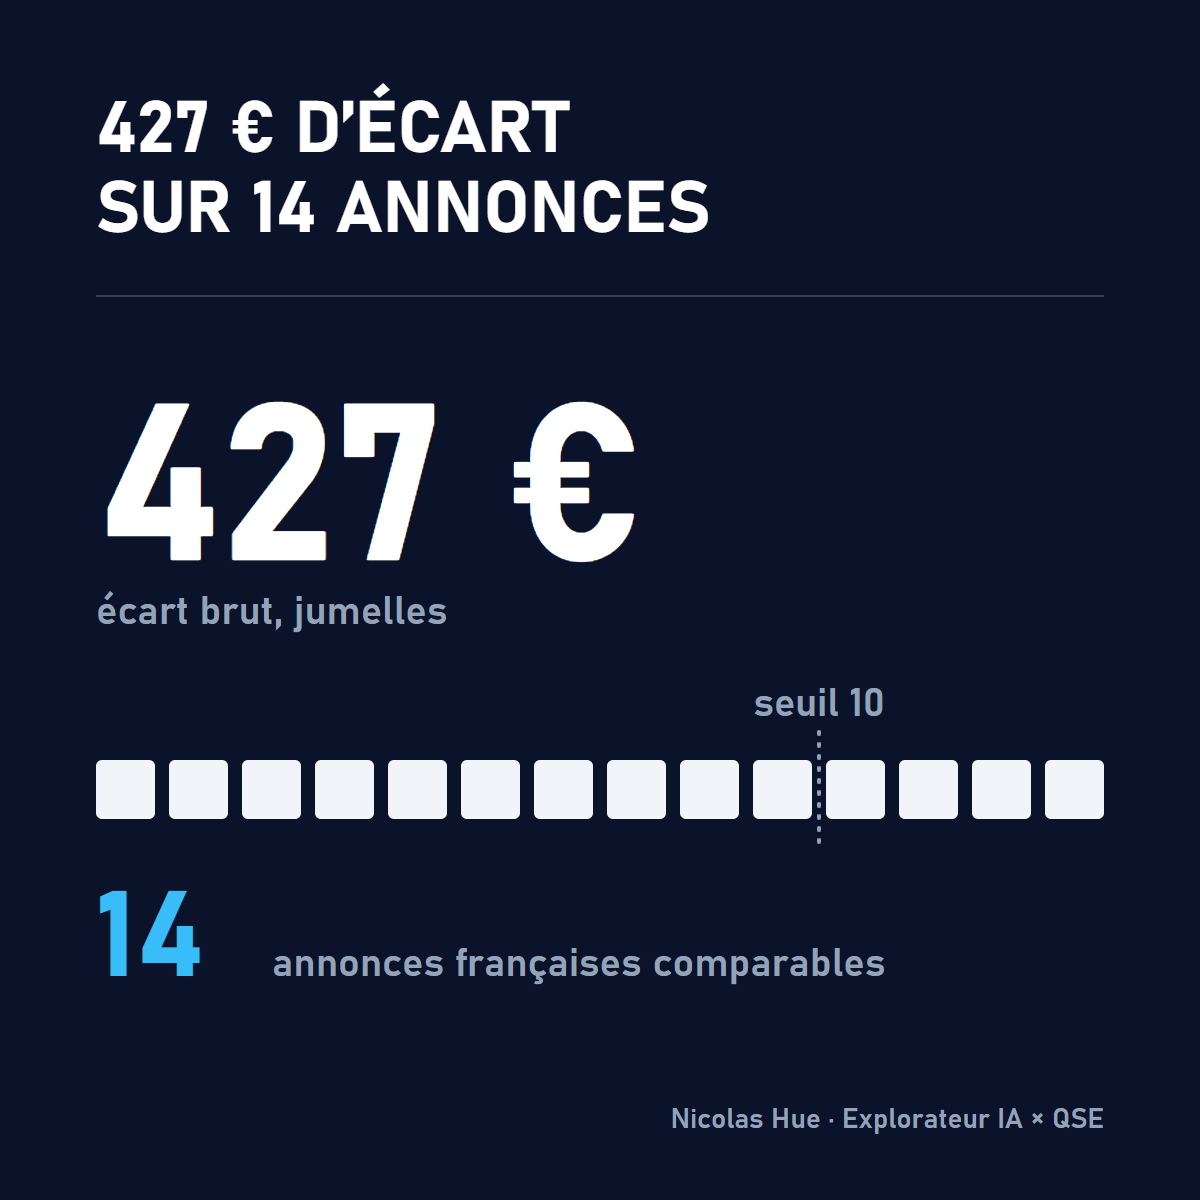
- Scan réel : 36 appels (12 candidats sur 3 marchés), code de sortie 0. Neuf candidats classés, trois écartés faute d’au moins 10 annonces françaises comparables.
Le classement lui-même demande de la prudence, et il le montre bien. Les jumelles arrivent en tête avec un écart brut de 427 euros (+260 %), mais sur 14 annonces françaises seulement et avec un flux de 0,1 annonce par jour côté États-Unis : une niche très peu fluide. Pour la photo argentique, prise comme témoin, le flux atteint 126,7 annonces par jour côté États-Unis contre 29,2 côté France. Ces flux mesurent le rythme d’arrivée des annonces, pas celui des ventes.
Autre limite : les prix sont des prix demandés. Le classement oriente la vérification manuelle, il ne la remplace pas.
6. Déploiement Zéro-Terminal (Le Mode d’Emploi pour Marc) : la même méthode dans un tableur
Aucune ligne de code n’est nécessaire pour appliquer ce raisonnement à un marché que vous suivez à la main. Un export de 200 lignes dans Excel suffit.
Créez quatre colonnes : prix, port, date de mise en ligne, pays du vendeur. Puis appliquez les trois règles :
- Le calibre. Dans une colonne de contrôle, gardez le prix seulement si le pays vaut « FR » et si le prix dépasse votre plancher :
=SI(ET(D2="FR";A2>=plancher);A2;""). - La médiane.
=MEDIANE(colonne_de_contrôle)ignore les cellules vides. Vous obtenez un prix de référence propre. - La cadence. Seulement si le nombre de résultats affichés par le site dépasse votre export :
=(NBVAL(dates)-1)/(MAX(dates)-MIN(dates)). Sinon, n’affichez rien. Un export complet ne mesure pas un rythme.
Le point à retenir pour un audit : consignez toujours la taille du lot, celle de l’échantillon et le calibre utilisé. Sans ces trois lignes, un chiffre de marché n’est pas traçable.
7. Les 3 Règles d’Or Actionnables & Conclusion : mesurer le lot avant de mesurer la pièce
- Un compteur lu après filtrage ne dit rien sur le prélèvement. Comparez la taille annoncée du lot à la taille de l’échantillon avant tout filtre.
- Un marché mêlant des fournisseurs de plusieurs pays impose un calibre de provenance. Filtrez sur la localisation avant de calculer une médiane de prix local.
- Un indicateur qui ne se calcule que dans un cas doit rendre « inconnu » dans les autres. Un chiffre approximatif affiché sans réserve est pire qu’une case vide.
Cette tranche n’est pas terminée pour autant. La tendance n’apparaîtra qu’au deuxième passage, une semaine plus tard, et la validation sur les sites de revente reste à faire à la main. C’est l’amélioration continue appliquée à un outil : un premier prélèvement, un calibre corrigé, puis un second contrôle pour confirmer ce que le premier suggérait.