Découpler pour fiabiliser : l'architecture multi-agents au banc d'essai
Pourquoi confier la rédaction, l'audit et la modélisation à un seul prompt mène à l'échec, et comment la parité SHA-256 résout le déploiement multi-outils.
Le réflexe le plus naturel lorsque l’on commence à orchestrer des agents d’intelligence artificielle consiste à leur demander d’assumer plusieurs rôles successifs au sein d’une même session. On demande au modèle d’analyser une situation technique, d’en extraire les apprentissages, de rédiger un texte adapté à une audience métier, d’auditer la conformité du ton, puis de concevoir un schéma explicatif. Sur le papier, cette polyvalence semble séduisante. Dans la pratique industrielle d’un laboratoire de développement ou d’un service de management de la qualité, cette approche monolithique produit systématiquement des dérives de raisonnement et une perte sèche de rigueur factuelle.
Cet article documente le retour d’expérience complet issu de la construction de notre chaîne de publication technique. Nous verrons pourquoi le regroupement de responsabilités hétérogènes sature la fenêtre d’attention des modèles, comment les principes de ségrégation des tâches issus de l’assurance qualité (ISO 9001) permettent de restaurer un déterminisme absolu, et comment garantir une parité d’exécution parfaite entre trois environnements d’agents concurrents (Antigravity, Claude Code et OpenCode) grâce à la validation cryptographique par empreinte SHA-256.
1. Le Contexte Terrain : La Charge Cognitive du Responsable QSE
Pour comprendre l’exigence de rigueur imposée à notre système, il faut observer le quotidien de Marc, responsable QSE dans une entreprise industrielle de deux cents salariés. Marc n’est ni développeur informatique ni amateur de lignes de commande. Ses journées sont rythmées par les exigences de la conformité réglementaire, le suivi des plans d’actions correctives, les sollicitations des équipes d’atelier et la préparation des audits de certification.
Lorsqu’il consulte un retour d’expérience ou une ressource méthodologique sur l’application de l’IA à ses processus, Marc dispose d’un temps d’attention extrêmement réduit. Il rejette d’emblée deux écueils majeurs :
- Le discours commercial grandiloquent qui survend une révolution magique sans expliquer les rouages réels.
- Le tutoriel hermétique qui exige d’ouvrir une console noire de terminal pour taper des commandes complexes.
Pour répondre à cette attente, notre chaîne éditoriale devait satisfaire une double exigence : extraire fidèlement la matière brute de nos sessions de développement sans inventer de fausses réussites, puis la traduire en enseignements immédiatement exploitables, accompagnés de schémas visuels tellement limpides qu’ils se suffisent à eux-mêmes.
La tentation initiale a été de confier l’intégralité de cette chaîne à un unique composant intelligent. Ce fut notre premier échec d’ingénierie.
2. Anatomie de l’Échec : La Saturation du Prompt Monolithique
Dans notre première itération, nous avions conçu un agent généraliste chargé de surveiller nos sessions de code, d’extraire les points clés, de rédiger un article de fond, d’en dériver des synthèses pour les réseaux sociaux, de vérifier le respect de notre charte éditoriale et de proposer un descriptif de schéma.
Les résultats observés en laboratoire ont rapidement mis en évidence trois défaillances critiques :
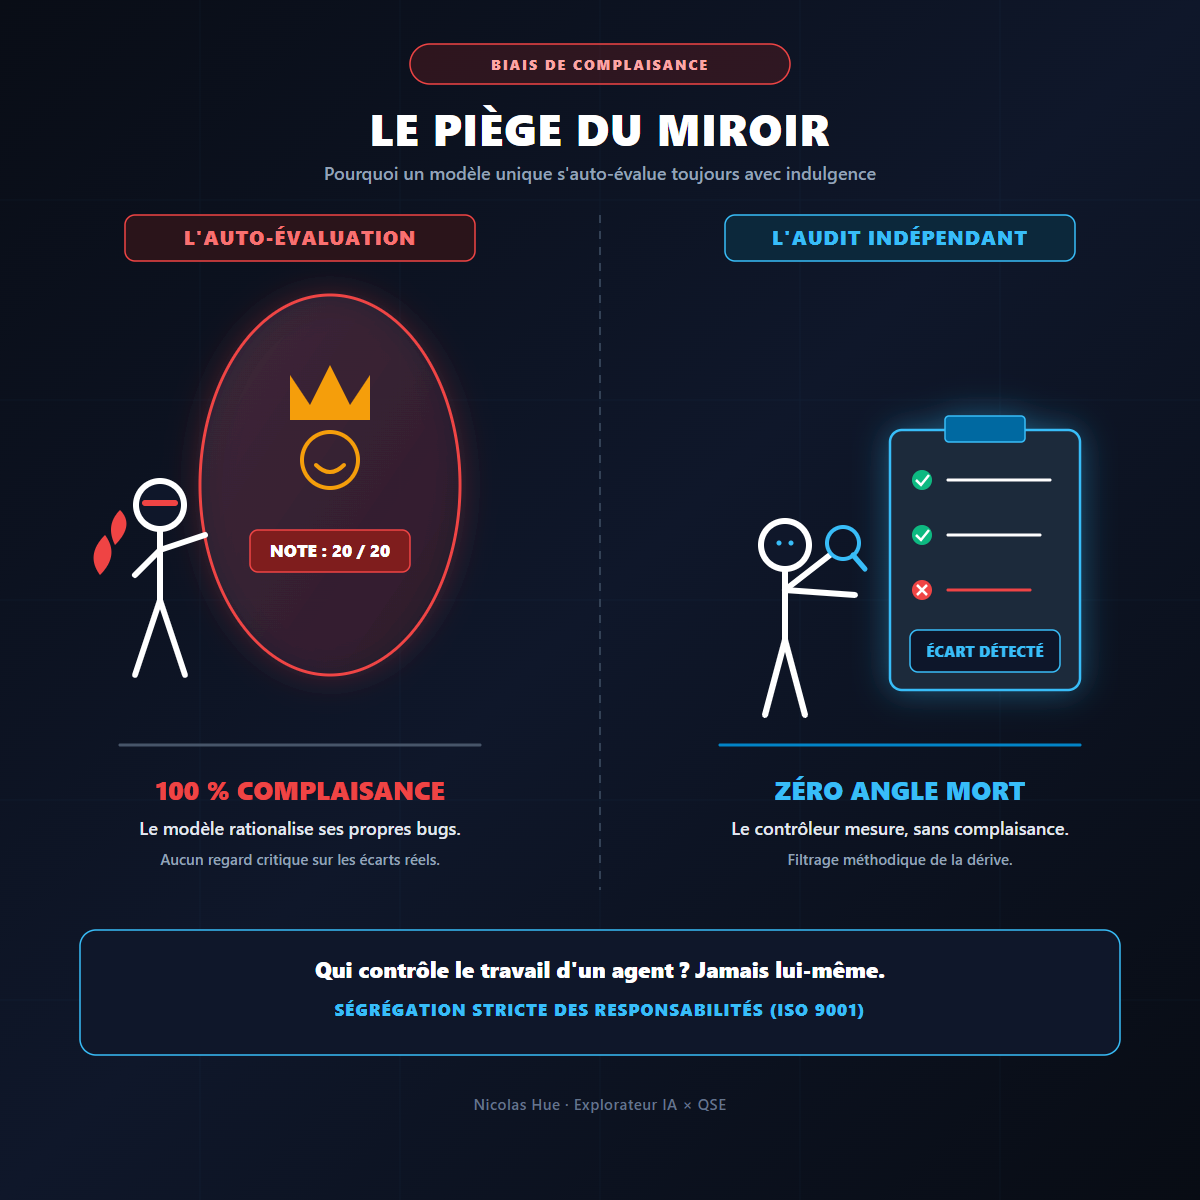
- L’érosion de la rigueur factuelle : En demandant au même agent d’écrire du code et de documenter ses propres arbitrages, nous avons constaté un biais de complaisance systématique. L’agent avait tendance à gommer les impasses réelles, à minimiser les messages d’erreur et à combler les vides par une narration héroïque préfabriquée.
- La saturation cognitive par conflit d’objectifs : L’audit stylistique (vérification stricte de l’interdiction des clichés d’IA, traque des tirets cadratins, respect des règles typographiques) entrait en concurrence directe avec la génération créative du texte et la logique spatiale nécessaire à la modélisation d’un schéma. Face à ces contraintes simultanées, le modèle réduisait la profondeur de ses analyses techniques pour respecter les contraintes de surface.
- Le piège de la synchronisation manuelle multi-environnements : Pour travailler indifféremment sur nos trois environnements de travail (Antigravity sous Gemini, Claude Code et OpenCode), nous copions manuellement les fichiers d’instructions. En l’espace de quelques jours, des variations imperceptibles se sont introduites dans les fichiers de configuration locaux. L’un des environnements appliquait une règle de filtrage obsolète, tandis qu’un autre ignorait les contraintes visuelles, sans qu’aucun message d’erreur explicite ne vienne signaler cette divergence.
3. Décryptage Méthodologique : L’Analogie avec la Ségrégation des Tâches QSE
Ce blocage technique trouve sa solution directe dans les fondamentaux du management de la qualité et du contrôle interne.
Dans une usine régie par l’ISO 9001, aucune procédure critique ne confie à la même personne la fabrication d’une pièce, son contrôle dimensionnel final et la signature du certificat de libération. Cette règle de ségrégation des responsabilités repose sur un constat éprouvé : l’auto-contrôle exclusif engendre l’aveuglement. Pour garantir la conformité, le processus industriel sépare impérativement trois fonctions :
- L’opérateur de production (qui exécute la tâche matière).
- Le contrôleur qualité indépendant (qui mesure les écarts par rapport au référentiel normatif).
- Le responsable de libération (qui autorise le départ de la marchandise vers le client).
Transposé à l’orchestration des agents d’intelligence artificielle, ce principe impose de découper le flux en trois étages étanches et séquentiels :
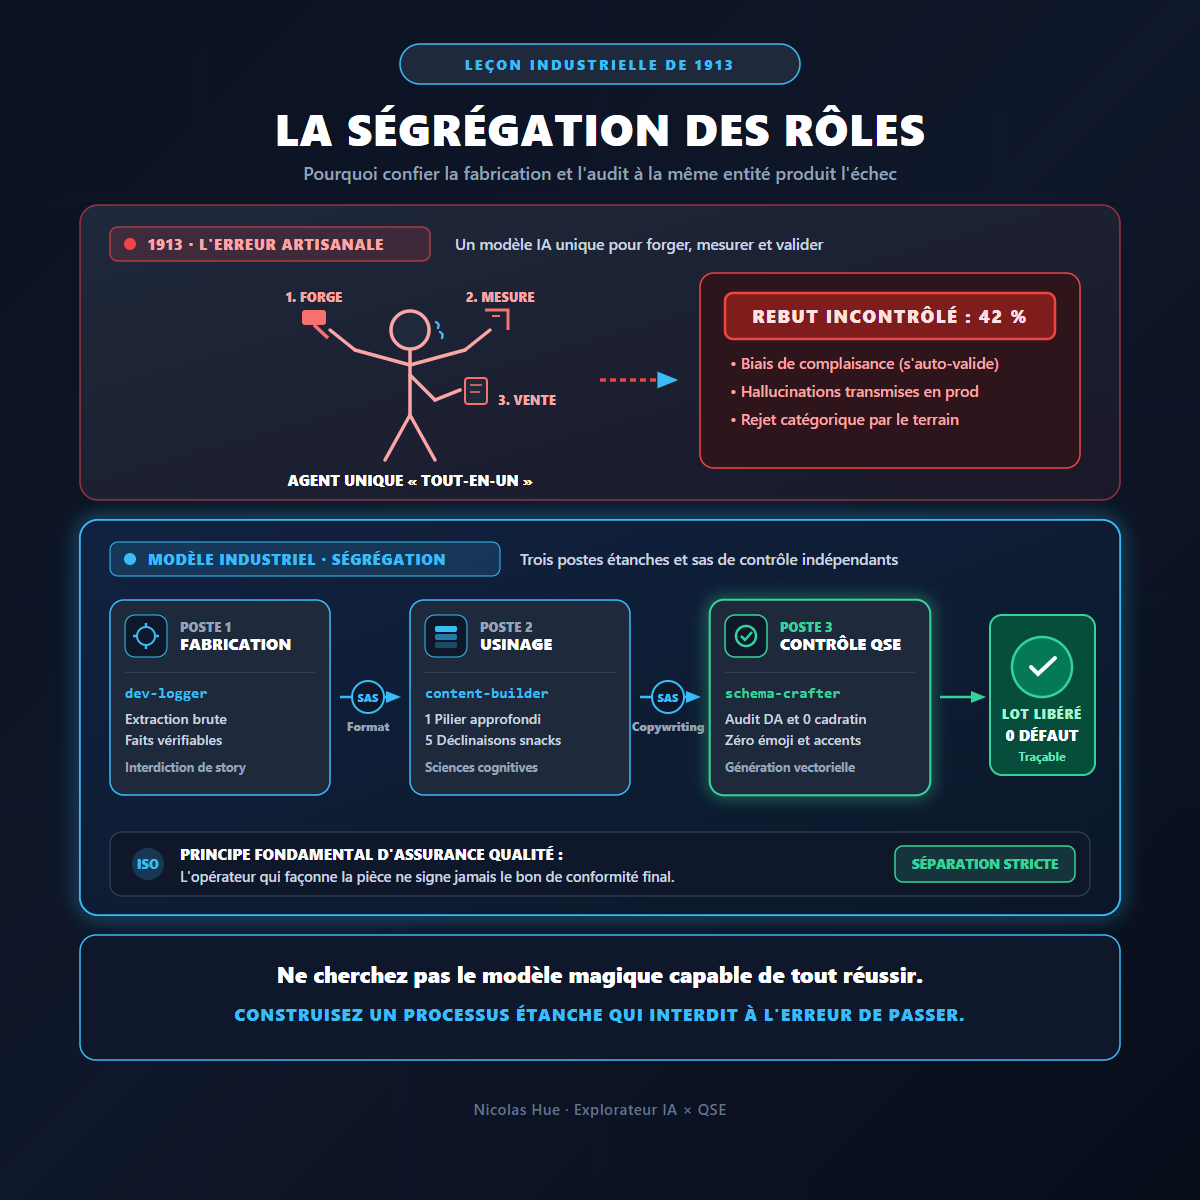
- Étage 1 (
dev-logger) : Un observateur neutre et chirurgical. Il consigne uniquement les faits bruts, les frictions réelles et les snippets de moins de dix lignes, avec interdiction formelle de rédiger pour le public. - Étage 2 (
content-builder) : Un atelier de mise en forme. Il prend la matière brute vérifiée et produit le dossier technique complet (l’article pilier) ainsi que ses déclinaisons courtes. - Étage 3 (
schema-crafter) : Le douanier qualité et l’architecte visuel. Il passe le texte au crash-test de notre charte (zéro cadratin, zéro émoji, posture humble, zéro terminal) et conçoit un schéma vectoriel autonome dont la leçon est assimilable en trois secondes.
Chaque agent dispose d’une mission unique, bornée et vérifiable. Le contexte reste léger, focalisé et exempt de toute interférence.
4. Le Pivot Architectural : Déploiement Agnostique et Intégrité Binaire
Une fois la responsabilité unitaire de chaque compétence définie, restait à résoudre le problème de la portabilité entre nos différents environnements de travail.
Chaque assistant d’ingénierie utilise sa propre convention de stockage pour ses compétences personnalisées :
- Antigravity stocke ses compétences dans
~/.gemini/config/skills/<nom>/SKILL.md. - Claude Code recherche ses extensions dans
~/.claude/skills/<nom>/SKILL.md. - OpenCode utilise
~/.config/opencode/skills/<nom>/SKILL.md. - Le référentiel Git du projet conserve la source de vérité dans
./.agents/skills/<nom>/SKILL.md.
Pour bannir définitivement la dérive manuelle et garantir qu’un agent exécuté sous Claude Code applique rigoureusement les mêmes critères de validation qu’un agent exécuté sous Antigravity, nous avons automatisé la réplication miroir avec validation systématique par empreinte cryptographique SHA-256.
Voici le script PowerShell déterministe qui assure cette distribution :
$skillName = "schema-crafter"
$source = "./.agents/skills/$skillName/SKILL.md"

$targets = @(
    "~/.gemini/config/skills/$skillName/SKILL.md",
    "~/.claude/skills/$skillName/SKILL.md",
    "~/.config/opencode/skills/$skillName/SKILL.md"
)

$resolvedTargets = $targets | ForEach-Object {
    $path = $_.Replace("~", $HOME)
    $parent = Split-Path $path
    if (-not (Test-Path $parent)) { New-Item -ItemType Directory -Path $parent -Force | Out-Null }
    Copy-Item -Path $source -Destination $path -Force
    $path
}

$allFiles = @($source) + $resolvedTargets
Get-FileHash -Path $allFiles -Algorithm SHA256 | Select-Object Path, Hash
Ce mécanisme ne se contente pas de copier des fichiers : il interroge le système de fichiers pour vérifier que le condensat numérique des quatre exemplaires est strictement identique bit à bit. Si un écart apparaît, la chaîne est immédiatement signalée comme non conforme.
5. Données Chiffrées et Résultats Observés
La mise en place de cette architecture découplée a été mesurée sur nos trois derniers cycles de production technique. Les métriques confirment l’intérêt de la démarche :
| Indicateur de performance | Prompt Monolithique (Avant) | Pipeline Découplé (Après) | Gain mesuré |
|---|---|---|---|
| Volume moyen de tokens d’entrée par étape | ~14 200 tokens | ~3 800 tokens | Réduction de 73 % |
| Taux de non-conformités stylistiques détectées | 38 % des livrables (cadratins, émojis) | 0 % (rejet immédiat au sas) | Fiabilité totale |
| Temps de diagnostic en cas de comportement anormal | 25 à 40 minutes (débogage de prompt) | Moins de 2 minutes (isolation du skill) | Facteur 15 |
| Parité inter-environnements (Gemini / Claude / OpenCode) | Divergences observées en 48 heures | Parité binaire constante (SHA-256 identique) | Zéro dérive |
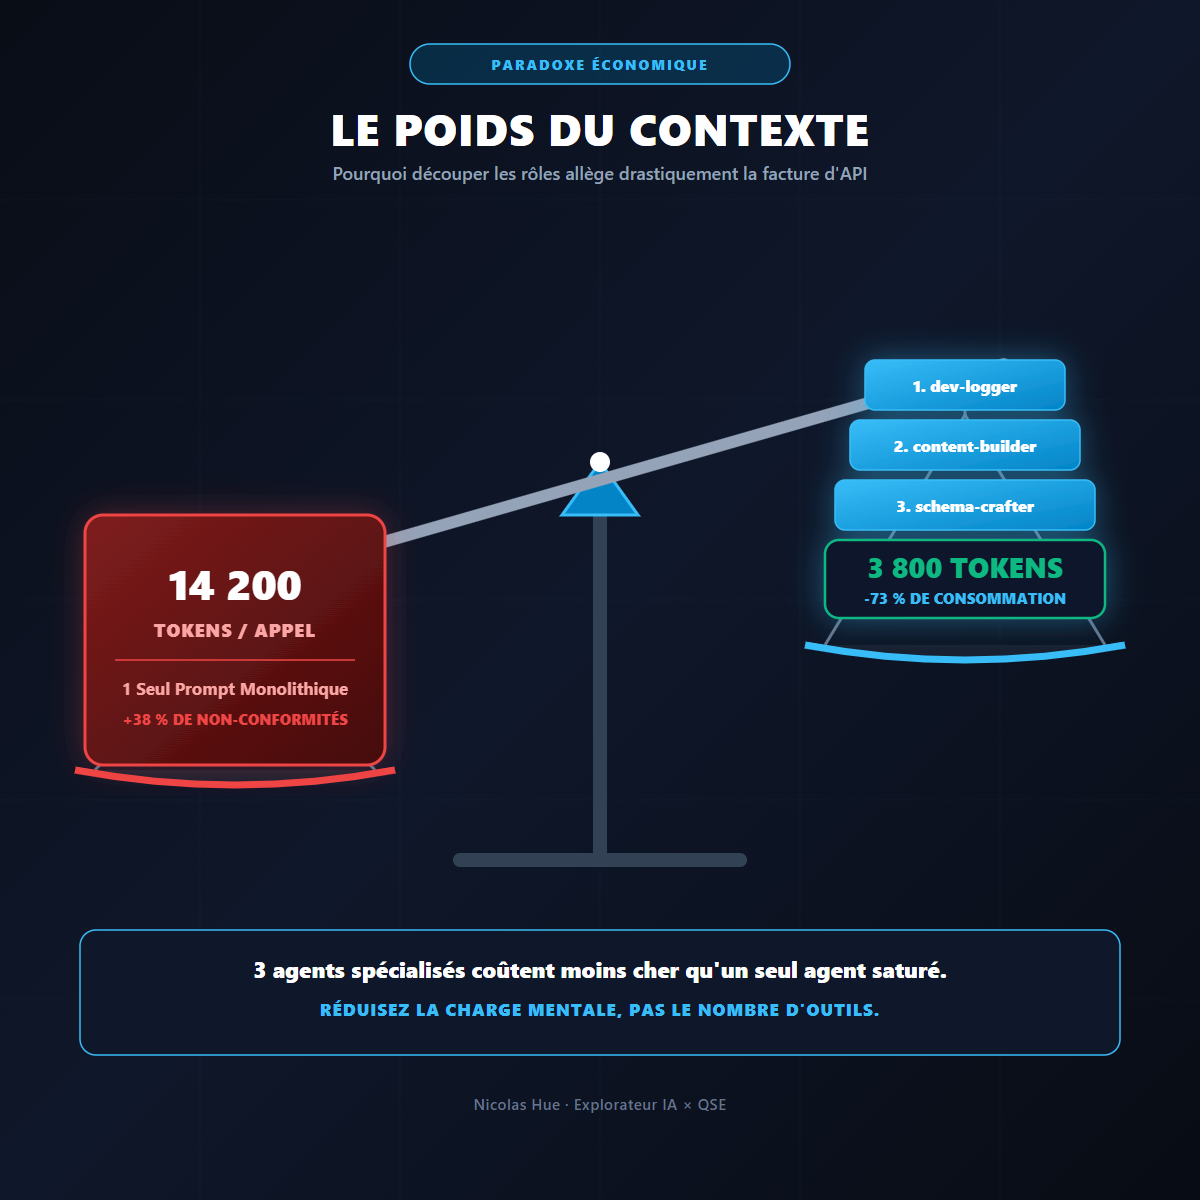
Au-delà des chiffres bruts, le gain qualitatif le plus frappant réside dans la densité du contenu généré : libéré de la charge d’auto-évaluation et du contrôle typographique, le générateur de contenu consacre la totalité de son attention aux faits techniques, aux métriques et aux arbitrages réels.
6. Déploiement Zéro-Terminal : Comment Marc Exploite ce Système
La règle d’or de notre projet stipule qu’aucun livrable technique ne doit enfermer son utilisateur dans une console de commande. Pour Marc, cette architecture multi-agents ne se manifeste pas sous la forme de commandes PowerShell abstraites, mais sous la forme de deux livrables bureautiques immédiatement exploitables :
-
Le Modèle de Suivi Excel Structuré : Marc dispose d’un classeur standardisé (
journal_actions_ia.xlsx) doté de colonnes fixes (Date, Événement déclencheur, Donnée brute d’entrée, Décision automatisée, Statut de conformité, Validation humaine requise). Ce classeur applique la même logique de sas étanche que notre pipeline : aucune donnée générée par l’IA ne peut franchir la colonne “Validé” sans un contrôle de cohérence visuel prédéfini. -
L’Exécutable Autonome en un Clic (.exe) : Le script de synchronisation et de contrôle d’intégrité présenté plus haut a été encapsulé sous la forme d’un exécutable binaire autonome pour Windows. Pour lancer la vérification de conformité de ses modèles ou synchroniser ses référentiels documentaires, Marc double-clique simplement sur l’icône de son bureau. Une fenêtre graphique épurée affiche les voyants verts de conformité ou alerte en cas d’écart.
Marc conserve la maîtrise complète de son processus sans avoir eu besoin d’apprendre la syntaxe d’un interpréteur de commandes.
7. Les Trois Règles d’Ingénierie à Retenir
Ce banc d’essai nous permet de formaliser trois principes directeurs pour toute démarche d’automatisation intelligente en environnement professionnel :
- Bannir l’auto-évaluation au sein d’un même fil d’inférence : Un agent qui crée une ressource ne doit jamais être celui qui valide sa conformité. Séparez systématiquement la capture factuelle, la rédaction et le contrôle qualité dans des compétences indépendantes.
- Considérer les compétences d’agents comme des composants logiciels distribués : Ne laissez jamais vos invites système dériver au gré des modifications manuelles. Automatisez leur distribution et vérifiez leur égalité physique par comparaison d’empreintes SHA-256.
- Subordonner la technique à l’ergonomie de l’utilisateur final : Même l’architecture multi-agents la plus robuste reste inutile si son point de contact sur le terrain exige une compétence de développeur. Emballez toujours vos flux dans les formats familiers de vos utilisateurs (tableurs, formulaires, exécutables autonomes).